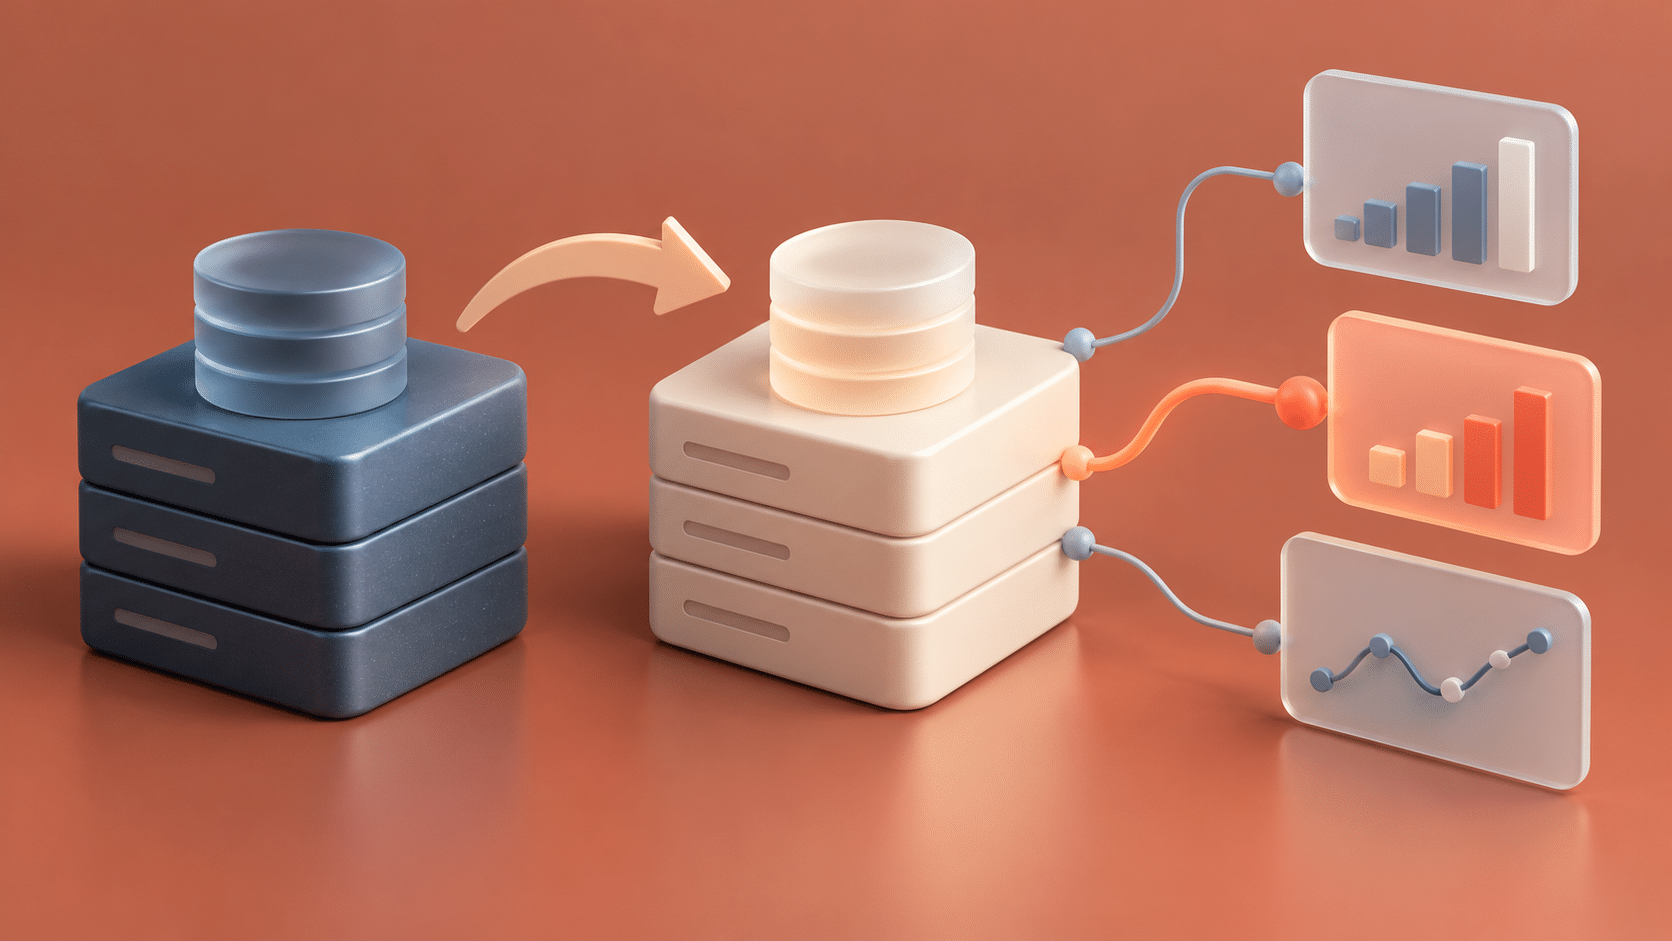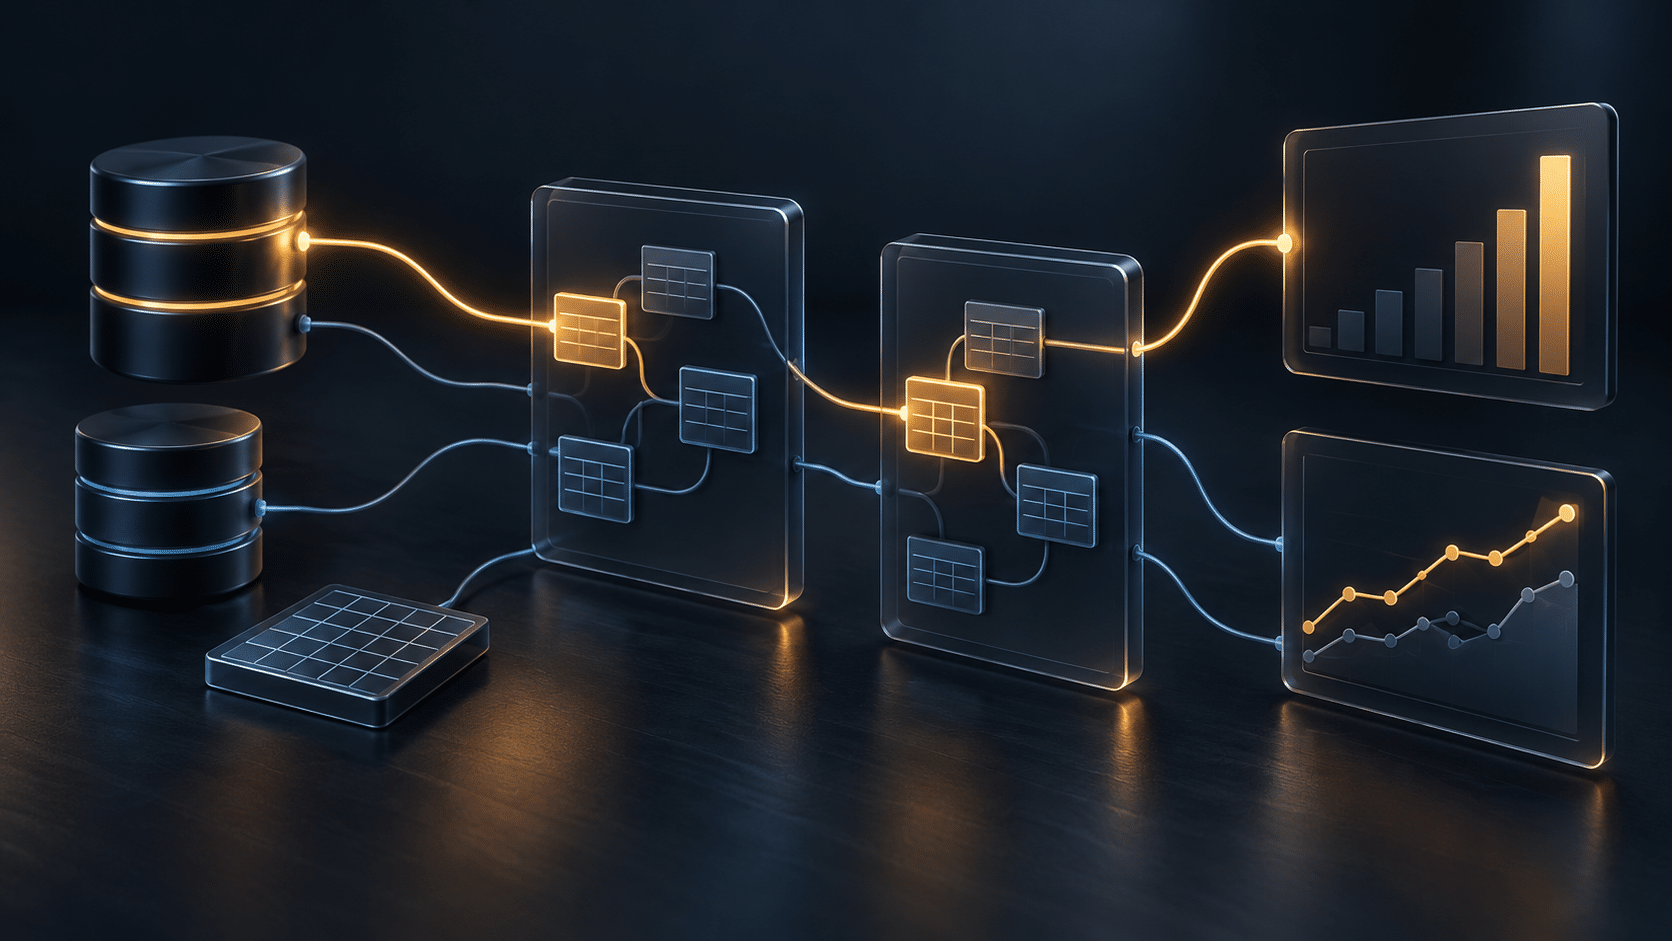
Unter „Data Lineage“ (oder Datenrückverfolgbarkeit) versteht man die Möglichkeit, den gesamten Weg eines Datensatzes von seiner Quelle (Datenbank, Datei, API, ERP) über alle Zwischenschritte bis hin zum endgültigen Bericht, den ein Fachanwender einsehen kann, nachzuverfolgen.
In einer ausgereiften Power BI -Umgebung wird diese Nachverfolgbarkeit schnell zu einem entscheidenden Faktor: Eine einfache Änderung des Spaltennamens in einer SQL-Quelle kann unbemerkt Dutzende von Berichten beeinträchtigen, die über Dutzende verschiedener Arbeitsbereiche verteilt sind und von Teams verwaltet werden, die unter Umständen noch nie miteinander kommuniziert haben.
Was die native Lineage-Funktion von Power BI bietet
Der Power BI-Dienst verfügt über eine Lineage-Ansicht, auf die direkt über die Benutzeroberfläche jedes Arbeitsbereichs zugegriffen werden kann. Diese ermöglicht es, die Beziehungen zwischen folgenden Elementen in Form eines Diagramms darzustellen:
- Datenflüsse,
- semantische Modelle (Datensätze),
- Berichte
- sowie die zu diesem Arbeitsbereich gehörenden Dashboards.
Diese Funktion ist im Arbeitsalltag für ein Team, das in einem begrenzten Bereich arbeitet, tatsächlich sehr nützlich, weist jedoch eine wesentliche strukturelle Einschränkung auf: Sie konzentriert sich jeweils nur auf einen Workspace.
Gemeinsam genutzte semantische Modelle aus anderen Arbeitsbereichen werden zwar deutlich angezeigt, und die Auswirkungsanalyse eines semantischen Modells listet die Elemente auf, die an anderer Stelle davon abhängen; die Datenquellen sind dort jedoch nur auf der Ebene des Berichts und des Arbeitsbereichs sichtbar: Es gibt keine Gesamtansicht auf Tenant-Ebene.
Die Grenzen der „Silo“-basierten Abstammungslinie
In der betrieblichen Praxis eines Unternehmens wird ein und dasselbe semantische Modell jedoch häufig von Berichten referenziert, die in anderen Arbeitsbereichen gehostet werden – manchmal von anderen Fachteams verwaltet – und zwar über gemeinsam genutzte Datensätze oder durch Live-Zusammensetzung (Composite Models).
Mithilfe der nativen Lineage-Funktion lassen sich diese Abhängigkeiten Objekt für Objekt ermitteln (vorausgesetzt, man denkt daran und verfügt über die entsprechenden Berechtigungen für die betreffenden Arbeitsbereiche), jedoch nicht auf einen Blick auf Tenant-Ebene.
Konkretes Ergebnis: Ein Team, das „sein“ Datenmodell ändert, stellt oft erst zu spät fest, dass Berichte anderer Abteilungen davon abhängig sind und dass es diese unwissentlich beeinträchtigen könnte.
Konkretes Beispiel
Ein Finanzteam ändert ein gemeinsames semantisches Modell, um eine neue analytische Dimension hinzuzufügen.
Drei Wochen später meldet das Vertriebsteam, dass sein Bericht zur Vertriebspipeline bereits seit einiger Zeit Rechenfehler aufweist, ohne dass die Ursache dafür ermittelt werden kann.
Ein bereichsübergreifendes Lineage hätte es ermöglicht, diese Auswirkungen bereits vor der Veröffentlichung der Änderungzu antizipieren.
Warum die vollständige Abstammungslinie eine entscheidende Rolle spielt
Eine auf den gesamten Tenant – über alle Workspaces hinweg – ausgeweitete Abstammungsstruktur ermöglicht es, Fragen zu beantworten, die sich andernfalls nicht zeitnah klären ließen:
- Wenn ich diese Quelltabelle ändere, welche Berichte in welchen Arbeitsbereichen und von welchen Teams verwaltet werden, sind davon betroffen?
- Welche semantischen Modelle werden von keinem aktiven Bericht mehr verwendet und können sicher archiviert werden?
- Wie sieht die vollständige Abhängigkeitskette eines strategischen Berichts aus, der monatlich im Vorstand vorgelegt wird?
- Wie viele „Sprünge“ (Hops) liegen zwischen einem Rohdatensatz und seiner letzten Visualisierung, und wo finden die entscheidenden Transformationen statt?
Abstammungslinie in absteigender Richtung vs. Abstammungslinie in aufsteigender Richtung
Es ist sinnvoll, zwei sich ergänzende Ansätze zur Analyse der Abstammungslinie zu unterscheiden:
- Aufsteigende Datenkette (Upstream): Geht von einem Bericht aus und führt zu dessen Quellen zurück: Dies ist hilfreich, um zu verstehen, woher die angezeigten Zahlen stammen, und um die Zuverlässigkeit einer Angabe zu überprüfen, bevor diese in einer Führungssitzung präsentiert wird.
- Abwärtsgerichtete Abhängigkeitsstruktur (Downstream): Sie geht von einer Datenquelle aus und erstreckt sich auf alle davon abhängigen Berichte; dies ist die unverzichtbare Übersicht vor jeder Änderung der Datenquelle, jeder Migration oder jeder Stilllegung eines Systems.
Ein häufiger Anwendungsfall: die Migration des Quellsystems
Bei einer ERP- oder CRM-Migration oder einem Wechsel des Data Warehouse lautet die erste Frage der Geschäftsleitung fast immer:
„Wie viele Berichte sind davon betroffen, und welche davon sind von entscheidender Bedeutung?“
Da keine Querverweise vorliegen, lautet die ehrliche Antwort des BI-Teams: „Wir wissen es nicht mit Sicherheit; das muss im Laufe der Zeit überprüft werden.“
Mit einer vollständigen und aktuellen Abstammungslinie wird diese Antwort zu einer einfachen Abfrage in einem zentralen Katalog, deren Ergebnisse innerhalb weniger Minuten vorliegen – statt erst nach mehreren Wochen manueller Recherche.
Dieses Thema wird in unserem Artikel zur Migration eines ERP-Systems, eines CRM-Systems oder einer geschäftskritischen Anwendung und deren Auswirkungen auf Power BI näher beleuchtet.
Einführung einer bereichsübergreifenden Herkunftsverfolgung: Die Methode
- Erfassen Sie die Metadaten aller Arbeitsbereiche über die Power BI Admin-API (Endpunkte in Bezug auf Datensätze, Datenflüsse, Berichte und deren deklarierte Beziehungen).
- Die Beziehungen zwischen Objekten über die Grenzen des Arbeitsbereichs hinweg wiederherstellen, indem insbesondere die gemeinsam genutzten Datensätze identifiziert werden, auf die in der Live-Komposition aus anderen Arbeitsbereichen verwiesen wird.
- Abgleich mit den in jedem semantischen Modell angegebenen externen Quellen (Datenbanken, Dateien, APIs), um die vollständige „
“-Kette von der Quelle bis zum Abschlussbericht zu erhalten. - Aktualisieren Sie diese Kartografie regelmäßig, da sich Arbeitsbereiche, Berichte und Verbindungen ständig weiterentwickeln: Eine unveränderliche Herkunftsverfolgung verliert schnell an Zuverlässigkeit.
Es handelt sich um eine technisch anspruchsvolle Grundlagenarbeit, wenn sie intern durchgeführt wird, die jedoch die Steuerungsfähigkeit eines Datenteams nachhaltig verändert, insbesondere bei Transformationsprojekten, an denen mehrere Quellsysteme beteiligt sind.
Häufig gestellte Fragen
Ist die native Lineage-Funktion von Power BI völlig nutzlos?
Nein, es ist nach wie vor nützlich, um sich schnell einen Überblick über die Struktur eines bestimmten Workspaces zu verschaffen und neue Teammitglieder einzuarbeiten. Seine Grenzen zeigen sich jedoch, sobald ein Gesamtüberblick erforderlich ist: Es lässt sich nur Workspace für Workspace oder Objekt für Objekt einsehen und bietet keine Übersicht über die Datenquellen auf Tenant-Ebene, obwohl dies in jeder Organisation, die in mehrere Fachteams gegliedert ist, ein gängiges Erfordernis ist.
Funktioniert „Transverse Lineage“ mit „Direct Query“ und den Composite-Modellen?
Ja, eine gut strukturierte transversale Abfrage muss alle drei Verbindungsmodi (Import, Direct Query, Composite) abdecken, da Abhängigkeiten zwischen gemeinsam genutzten semantischen Modellen unabhängig davon entstehen, welchen Modus der Abfrageverbraucher verwendet.
Wie lange dauert es, bis man einen vollständigen und zuverlässigen Stammbaum erhält?
Dieses Projekt, das intern auf Basis der Admin-APIs entwickelt wurde, nimmt je nach Größe des Mandanten in der Regel einige Tage bis zu einigen Wochen in Anspruch. Der größte Aufwand liegt jedoch nicht in der anfänglichen Erstellung, sondern in der langfristigen Wartung (Weiterentwicklungen der APIs, neue Arbeitsbereiche, neue Datenquellen), damit die Zuordnung stets auf dem neuesten Stand bleibt. Genau hier macht eine spezielle, kontinuierlich aktualisierte Lösung den Unterschied.
Siehe auch: „Migration von ERP-, CRM- oder geschäftskritischen Anwendungen“, in dem die bereichsübergreifende Herkunftsverfolgung konkret auf ein Migrationsprojekt angewendet wird, sowie „Power BI-Bestandsaufnahme“, die die für jede zuverlässige Herkunftsverfolgung erforderliche Datenbank bildet.