Le data lineage (ou traçabilité des données) désigne la capacité à suivre le parcours complet d’une donnée, depuis sa source (base de données, fichier, API, ERP) jusqu’au rapport final consulté par un utilisateur métier, en passant par toutes les transformations intermédiaires.
Dans un environnement Power BI mature, cette traçabilité devient rapidement critique : un simple changement de nom de colonne dans une source SQL peut casser silencieusement des dizaines de rapports répartis dans des dizaines de workspaces différents, gérés par des équipes qui n’ont parfois jamais communiqué entre elles.
Ce que propose le lineage natif de Power BI
Power BI Service intègre une vue de lineage directement accessible depuis l’interface de chaque workspace. Elle permet de visualiser sous forme de diagramme les relations entre :
- dataflows,
- modèles sémantiques (datasets),
- rapports
- et dashboards appartenant à ce workspace.
C’est une fonctionnalité réellement utile au quotidien pour une équipe qui travaille dans un périmètre limité, mais elle présente une limite structurelle majeure : elle reste centrée sur un workspace à la fois.
Elle signale bien les modèles sémantiques partagés provenant d’autres workspaces, et l’analyse d’impact d’un modèle sémantique liste les éléments qui en dépendent ailleurs, mais les sources de données n’y sont visibles qu’au niveau du rapport et du workspace : il n’existe pas de vue globale à l’échelle du tenant.
La limite du lineage « en silo »
Or, dans la réalité opérationnelle d’une entreprise, un même modèle sémantique est fréquemment référencé par des rapports hébergés dans d’autres workspaces, parfois gérés par d’autres équipes métier, via les datasets partagés ou la composition en direct (composite models).
Le lineage natif permet de retrouver ces dépendances objet par objet (à condition d’y penser et d’avoir les droits sur les workspaces concernés), mais pas de les voir d’un coup d’œil à l’échelle du tenant.
Résultat concret : une équipe qui modifie « son » modèle de données découvre souvent trop tard les rapports d’autres services qui en dépendent, et qu’elle risque de casser sans le savoir.
Cas concret
Une équipe finance modifie un modèle sémantique partagé pour ajouter une nouvelle dimension analytique.
Trois semaines plus tard, l’équipe commerciale signale que son rapport de pipeline de ventes affiche des erreurs de calcul depuis un moment déjà, sans pouvoir en identifier la cause.
Un lineage transverse aurait permis d’anticiper cet impact avant même de publier la modification.
Pourquoi le lineage complet change la donne
Un lineage étendu à l’ensemble du tenant, tous workspaces confondus, permet de répondre à des questions autrement impossibles à traiter rapidement :
- Si je modifie cette table source, quels rapports, dans quels workspaces et gérés par quelles équipes, seront impactés ?
- Quels modèles sémantiques ne sont plus utilisés par aucun rapport actif et peuvent être archivés en toute sécurité ?
- Quelle est la chaîne de dépendance complète d’un rapport stratégique présenté chaque mois en comité de direction ?
- Combien de « sauts » (hops) séparent une donnée brute de sa dernière visualisation, et où se situent les transformations critiques ?
Lineage descendant vs lineage ascendant
Il est utile de distinguer deux directions d’analyse du lineage, complémentaires :
- Lineage ascendant (upstream) : part d’un rapport et remonte vers ses sources : utile pour comprendre d’où viennent les chiffres affichés, et vérifier la fiabilité d’une donnée avant de la présenter en réunion de direction.
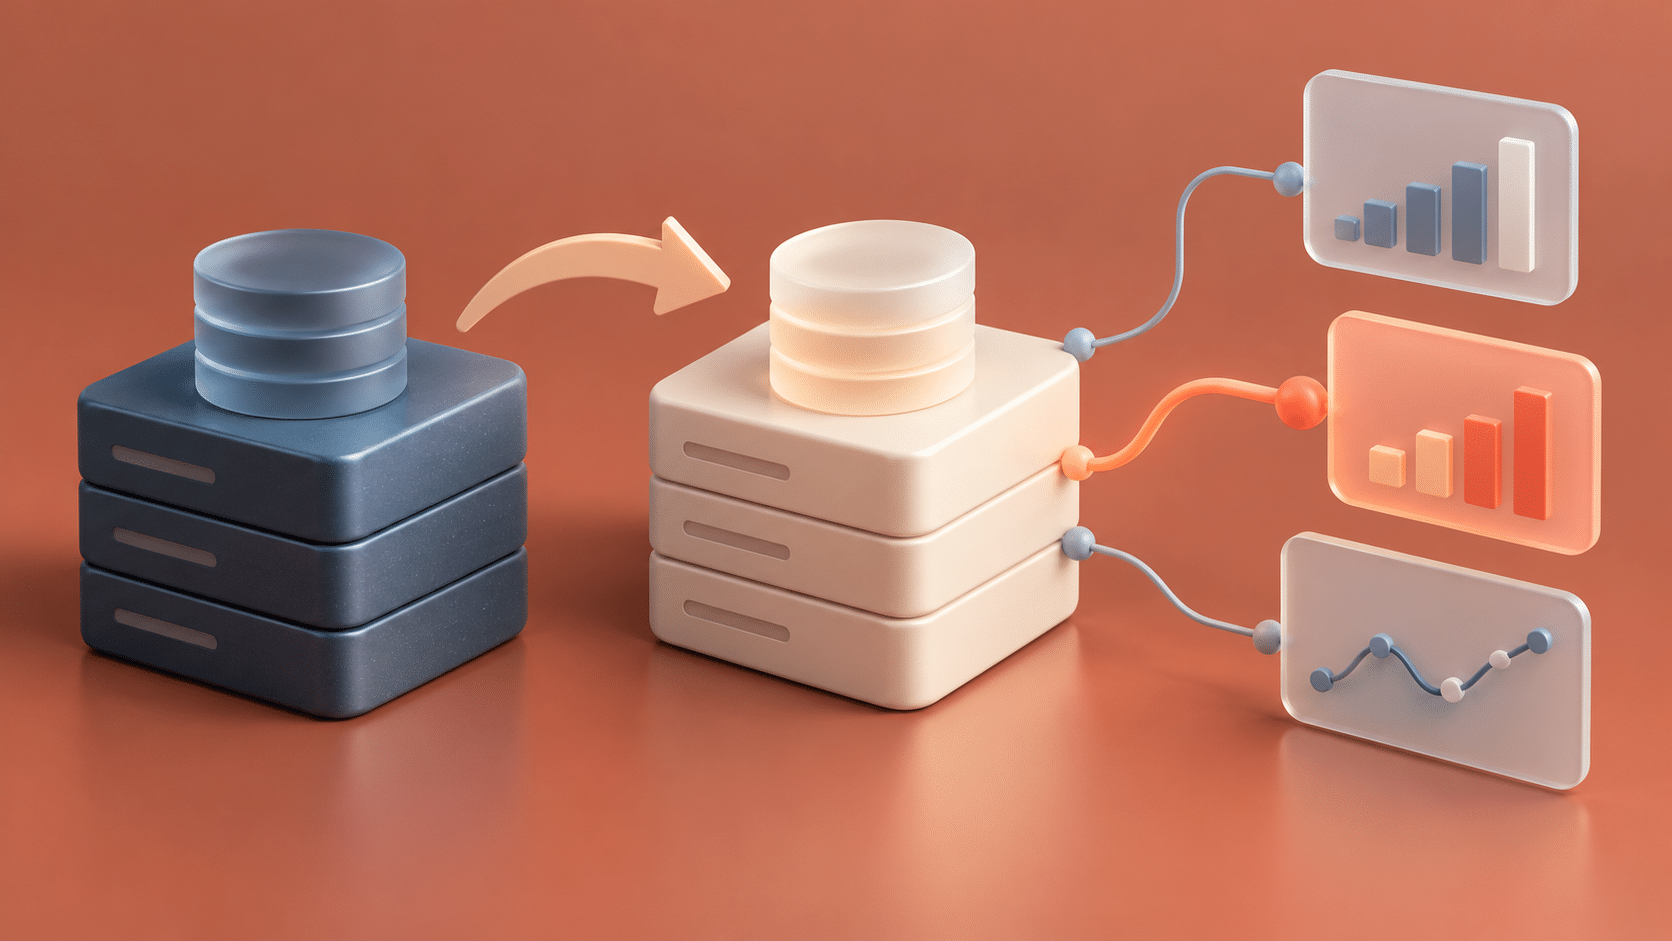
- Lineage descendant (downstream) : part d’une source de données et descend vers tous les rapports qui en dépendent : c’est la vue indispensable avant tout changement de source, migration ou décommissionnement d’un système.
Un cas d’usage fréquent : la migration de système source
Lors d’une migration ERP, CRM ou d’un changement d’entrepôt de données, la première question posée par la direction est presque toujours la même :
« Combien de rapports seront impactés, et lesquels sont critiques ? »
Sans lineage transverse, la réponse honnête de l’équipe BI est : « nous ne savons pas avec certitude, il faudra vérifier au fur et à mesure ».
Avec un lineage complet et à jour, cette réponse devient une simple requête sur un catalogue centralisé, disponible en quelques minutes plutôt qu’en plusieurs semaines d’investigation manuelle.
Ce sujet est approfondi dans notre article dédié à la migration d’un ERP, d’un CRM ou d’une application métier critique et son impact sur Power BI.
Mettre en place un lineage transverse : la méthode
- Collecter les métadonnées de l’ensemble des workspaces via l’API Power BI Admin (endpoints liés aux datasets, dataflows, rapports et leurs relations déclarées).
- Reconstruire les relations entre objets au-delà des frontières de workspace, en identifiant notamment les datasets partagés référencés en composition en direct depuis d’autres workspaces.
- Croiser avec les sources externes (bases de données, fichiers, API) déclarées dans chaque modèle sémantique, pour obtenir la chaîne
complète depuis la source jusqu’au rapport final. - Rafraîchir régulièrement cette cartographie, car les workspaces, rapports et connexions évoluent en continu : un lineage figé perd rapidement de sa fiabilité.
C’est un travail de fond techniquement exigeant s’il est mené en interne, mais qui transforme durablement la capacité de gouvernance d’une équipe data, en particulier lors de projets de transformation impliquant plusieurs systèmes source.
Questions fréquentes
Le lineage natif de Power BI est-il totalement inutile ?
Non, il reste utile pour comprendre rapidement la structure d’un workspace donné et former de nouveaux membres d’une équipe. Sa limite apparaît dès qu’il faut une vue globale : il se consulte workspace par workspace ou objet par objet, et ne donne pas de cartographie des sources de données à l’échelle du tenant, alors que c’est un besoin courant dans toute organisation structurée en plusieurs équipes métier.
Le lineage transverse fonctionne-t-il avec Direct Query et les composite models ?
Oui, un lineage transverse bien construit doit couvrir les trois modes de connexion (import, Direct Query, composite) car les dépendances entre modèles sémantiques partagés se créent quel que soit le mode utilisé par le rapport consommateur.
Combien de temps faut-il pour obtenir un lineage complet et fiable ?
Développé en interne à partir des API Admin, ce type de projet demande généralement de quelques jours à quelques semaines selon la taille du tenant. Mais le plus exigeant n’est pas la construction initiale : c’est la maintenance dans la durée (évolutions des API, nouveaux workspaces, nouvelles sources) pour que la cartographie reste à jour. C’est là qu’une solution dédiée, mise à jour en continu, fait la différence.
Voir aussi : « Migration ERP, CRM ou application métier critique », qui applique concrètement le lineage transverse à un projet de migration, et « Inventaire Power BI », qui constitue la base de données nécessaire à tout lineage fiable.