Les projets de migration de système d’information (changement d’ERP, de CRM, d’une application métier critique, ou modernisation de l’entrepôt de données) figurent parmi les initiatives les plus risquées pour un environnement Power BI mature. Une source de données modifiée, renommée ou supprimée peut casser silencieusement des dizaines de rapports, parfois utilisés par la direction générale pour des décisions stratégiques hebdomadaires.
Le problème classique : découvrir l’impact trop tard
Dans beaucoup de projets de migration, l’équipe BI n’est associée qu’en fin de projet, une fois la nouvelle source de données prête et le système legacy déjà en voie de décommissionnement. Elle découvre alors, souvent dans l’urgence et sous forte pression calendaire, l’ampleur réelle des rapports à reconstruire : un travail qui aurait pu être anticipé plusieurs mois plus tôt si la cartographie des dépendances avait été disponible dès le lancement du projet de migration.
Pourquoi le lineage natif de Power BI ne suffit pas ici
Comme détaillé dans notre article dédié au data lineage, le lineage natif de Power BI reste centré sur un workspace à la fois : les sources de données n’y sont visibles qu’au niveau du rapport et du workspace, sans vue globale du tenant. Or la migration d’un ERP, d’un CRM ou d’une application métier critique touche généralement des sources de données consommées par des dizaines de workspaces différents, gérés par des équipes métier distinctes (finance, ventes, supply chain, ressources humaines) qui n’ont souvent aucune visibilité les unes sur les autres. Sans vue transverse à l’ensemble du tenant, il est impossible d’obtenir une réponse fiable à la question pourtant centrale : « Sommes-nous certains d’avoir recensé tous les rapports qui utilisent cette source ? »
La méthode complète : cartographier avant de migrer
Étape 1 : Identifier précisément les sources concernées
Lister exhaustivement les tables, bases de données, API ou fichiers exposés par le système actuel et qui seront modifiés, renommés ou retirés lors de la migration.
Étape 2 : Extraire la liste des modèles sémantiques connectés
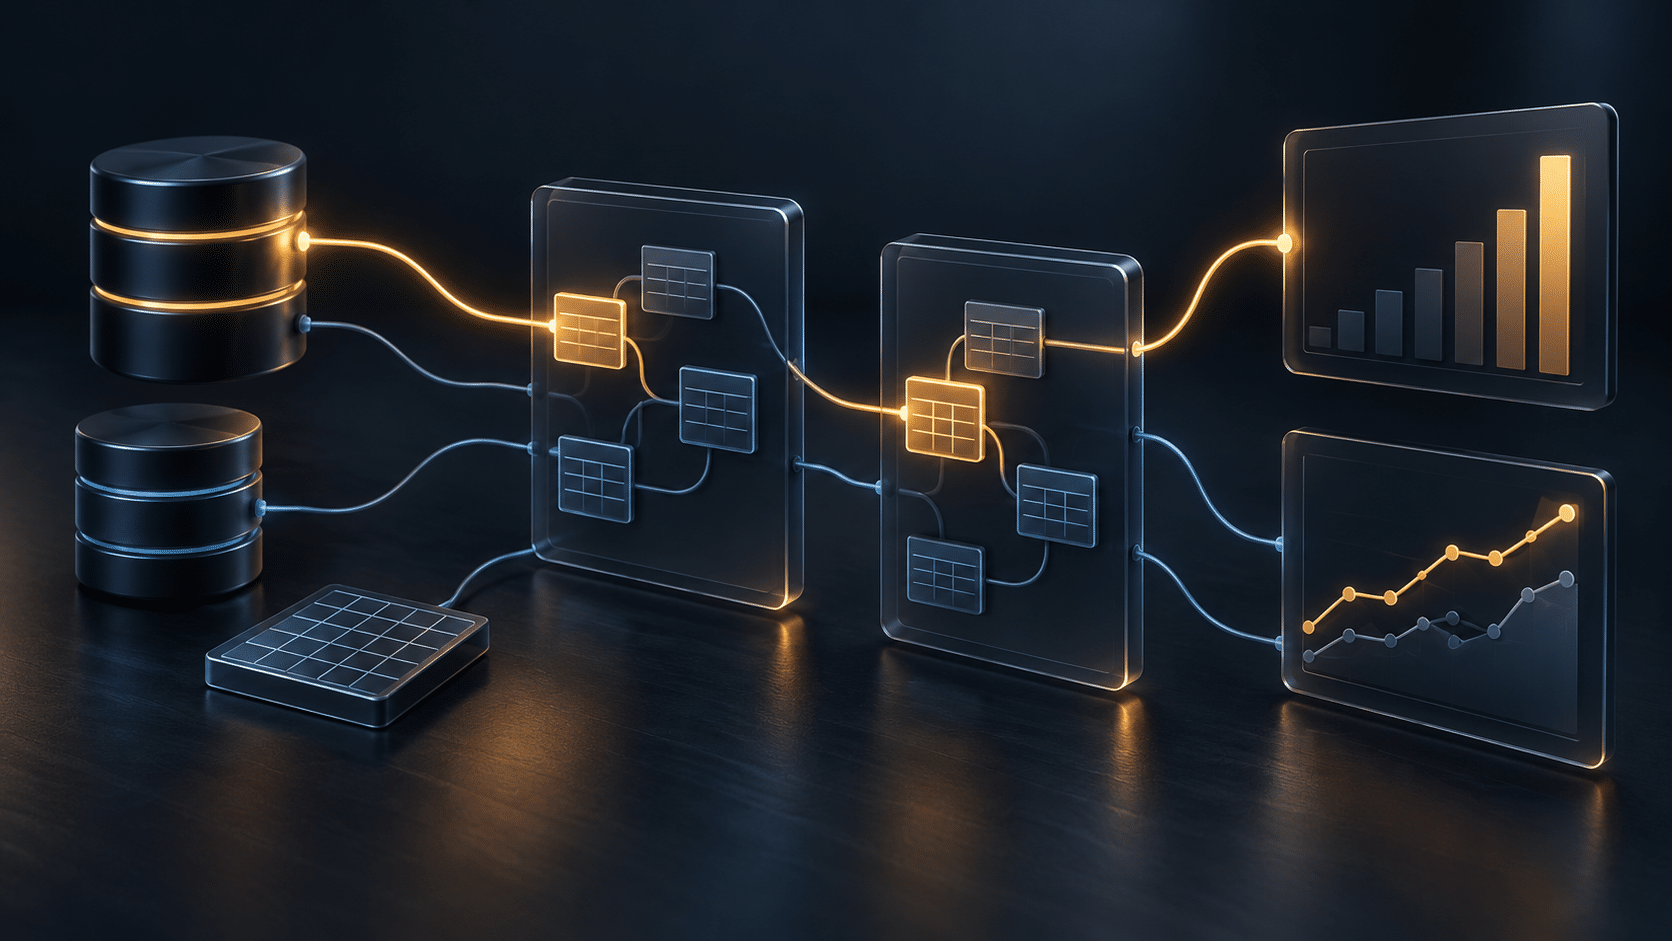
Via le lineage transverse, identifier tous les modèles sémantiques Power BI, tous workspaces confondus, qui se connectent directement ou indirectement à ces sources, y compris via des composite models ou des datasets partagés en composition en direct.
Étape 3 : Remonter jusqu’aux rapports et dashboards finaux
Pour chaque modèle sémantique identifié, remonter la chaîne jusqu’aux rapports et dashboards qui le consomment, afin d’obtenir la liste complète et exhaustive des artefacts finaux impactés, avec leurs propriétaires respectifs.
Étape 4 : Prioriser la remédiation
Classer les rapports impactés selon leur criticité métier (utilisé en comité de direction, utilisé par une seule personne, rapport de test abandonné) et leur nombre d’utilisateurs actifs, pour concentrer l’effort de reconstruction sur ce qui compte réellement plutôt que de traiter tous les rapports avec la même priorité.
| Niveau de priorité | Critère | Action recommandée |
|---|---|---|
| Critique | Utilisé en comité de direction, forte audience | Reconstruction anticipée, test en parallèle avant bascule |
| Important | Utilisé régulièrement par une équipe métier | Planification dans le calendrier du projet de migration |
| Secondaire | Usage faible mais propriétaire actif identifié | Reconstruction différée, communication au propriétaire |
| À archiver | Aucun usage récent, pas de propriétaire actif | Ne pas reconstruire, archiver |
Un bénéfice qui dépasse le seul projet de migration
Une fois cette cartographie établie pour un projet de migration donné, elle ne doit pas être considérée comme un livrable jetable. Elle constitue la base d’un lineage vivant, réutilisable pour tout changement futur : évolution ultérieure d’un schéma de données, décommissionnement d’une autre application legacy, fusion de deux équipes ou de deux systèmes suite à une réorganisation.
Anticiper plutôt que réparer
La différence entre un projet de migration maîtrisé et un projet chaotique tient souvent à un seul facteur déterminant : la capacité à anticiper l’impact avant que le changement ne soit déployé en production, plutôt que de le découvrir après coup à travers les remontées d’utilisateurs mécontents et les rapports qui affichent brutalement des erreurs ou des données incohérentes.
Questions fréquentes
À quel moment du projet de migration faut-il associer l’équipe BI ?
Idéalement dès le cadrage initial du projet, avant même la sélection définitive du nouveau système, pour que la cartographie d’impact puisse influencer le calendrier global et éviter les découvertes tardives coûteuses en fin de projet.
Faut-il reconstruire tous les rapports impactés avant la bascule ?
Pas nécessairement tous en même temps : une priorisation par criticité métier permet souvent de basculer avec les rapports les plus importants prêts, et de traiter les rapports secondaires dans les semaines suivant la mise en production du nouveau système.
Le lineage transverse fonctionne-t-il aussi pour anticiper des changements plus mineurs qu’une migration complète ?
Oui, la même méthode s’applique à tout changement de source, même limité (ajout ou suppression d’une colonne, changement de type de données, renommage d’une table), qui peut avoir un impact disproportionné sur les rapports en aval.
Cet article s’appuie directement sur la méthode décrite dans « Data lineage dans Power BI ». Voir aussi « Inventaire Power BI » pour disposer de la base de données nécessaire à toute cartographie d’impact.