Repérer des anomalies, interroger les données en langage naturel, accélérer le diagnostic : les plateformes d’observabilité intègrent l’IA pour élargir ce que les équipes peuvent analyser.
Jusqu’où peut-on se fier à ces outils, et de quelles informations ont-ils besoin pour fournir des réponses utiles ?
Notre expérience montre que leur efficacité dépend en grande partie de la qualité des informations mises à leur disposition. Une expérimentation de Grafana l’illustre : un agent IA a été évalué avec ou sans accès au Knowledge Graph, la couche de contexte de Grafana Cloud qui cartographie les composants du système, leurs relations et leur état de fonctionnement.
En analysant un incident réel rejoué, l’agent a trouvé la cause correcte dans 15 essais sur 16 avec le graphe, contre 1 sur 16 avec la seule télémétrie. Toutefois, sur un autre incident, l’ajout du graphe n’a pas apporté d’amélioration significative.
À partir de ces résultats et des retours de terrain des équipes Qim info, nous examinons les usages, les prérequis et les moyens d’évaluer l’IA pour l’observabilité dans votre environnement.
Les points clés à retenir :
- L’IA peut automatiser des tâches précises. Son rôle dépasse celui d’un assistant conversationnel.
- Le contexte compte autant que les métriques disponibles pour interpréter un résultat.
- Un diagnostic plausible reste à vérifier.
- L’autorisation d’analyser donnée à l’IA n’est pas une autorisation d’agir.
À quoi sert l’IA dans une démarche d’observabilité ?
Au-delà du temps gagné, l’IA rend accessibles des analyses difficiles à mener manuellement :
- repérer des anomalies dans des données multidimensionnelles,
- explorer de très grands volumes de logs,
- comprendre du code écrit dans un langage que l’équipe maîtrise peu.
Ces capacités ouvrent de nouvelles pistes pour détecter et résoudre les problèmes.
Détecter les anomalies et regrouper les alertes liées
L’IA permet de repérer des écarts que des seuils fixes laisseraient passer, en analysant le comportement habituel du système.
Exemple : une application peut ralentir sans franchir son seuil d’alerte. Si elle répond habituellement en 100 à 200 ms et passe durablement à 600 ms, un seuil fixé à une seconde ne signalera rien ; mais un modèle qui analyse son comportement habituel peut repérer cet écart.
L’IA aide aussi à examiner ensemble les alertes liées à un même incident. Une défaillance peut provoquer une cascade de symptômes :
Imaginons :
- une base de données qui ralentit ;
- les API qui l’interrogent mettent plus de temps à répondre ;
- des requêtes utilisateurs finissent par expirer.
Faut-il ouvrir trois investigations distinctes ?
L’outil peut rapprocher ces signaux en examinant leur chronologie et les dépendances entre les composants. L’équipe dispose alors d’un ensemble de symptômes à examiner conjointement. Et surtout, n’oubliez pas que “lié” ne signifie pas “cause prouvée”.
Ces usages sont documentés par Dynatrace pour les références de comportement et la détection d’anomalies
💡L’avis de Qim info : ciblez les difficultés rencontrées par vos équipes. Des dégradations passent sous les seuils ? Évaluez la détection comportementale. Plusieurs alertes mobilisent des investigations séparées pour un même incident ? Évaluez leur regroupement. Mesurez ensuite les dégradations effectivement détectées et le travail nécessaire pour traiter les alertes.
👉 Quels indicateurs afficher et comment organiser votre tableau de bord ? Notre article sur l’IT Performance Dashboard détaille ces choix. Pour définir les composants à surveiller et les alertes à mettre en place, consultez notre guide du monitoring IT.
Explorer les données en langage naturel
Explorer les données d’observabilité demande souvent de savoir comment les interroger. Le langage naturel réduit cette barrière technique : l’utilisateur formule ce qu’il cherche, et l’assistant prend en charge la construction des requêtes.
« Quels services présentent une hausse du taux d’erreur depuis 14 h ? »
À partir de cette question, l’assistant interroge les sources connectées et présente les résultats. L’utilisateur peut alors approfondir :
- « Concentre-toi sur le service de paiement. »
- « Compare son taux d’erreur avec la même période hier. »
- « Affiche les logs ou les traces associés à ces erreurs. »
Pour un collaborateur peu familier des langages de requête, cela ouvre un accès plus direct à l’exploration des données.
Pour un expert, cela permet de déléguer la rédaction des requêtes et de se concentrer sur les pistes à examiner.
L’apport dépasse donc la simplification d’une requête : l’assistant accompagne une exploration qui se précise au fil des résultats. L’utilisateur conserve la direction de l’analyse et vérifie que la période, l’environnement et les filtres retenus correspondent à sa question.
👉 Pour approfondir les temps de chargement, les Core Web Vitals et la mise en cache, consultez notre article sur la performance des applications web. Notre guide sur la performance des applications mobiles aborde notamment la fluidité de l’interface, la consommation de mémoire et de batterie, ainsi que les contraintes réseau.
Aider au diagnostic et synthétiser les incidents
Retour de terrain : des investigations complexes menées quelques minutes, contre une journée auparavant
Alan, ingénieur chez Qim info, évoque des investigations complexes désormais menées en 30 à 60 minutes, contre une journée auparavant. Ce retour illustre le gain possible ; il reste à mesurer dans chaque environnement.
L’assistant peut explorer plusieurs sources, rapprocher les symptômes et construire des hypothèses étayées. L’équipe dispose ainsi d’une première analyse à vérifier et à approfondir.
Les erreurs augmentent depuis 14 heures, après un déploiement. Pour rechercher leur origine, l’assistant peut examiner :
- quels services et quelles requêtes sont touchés ;
- ce qui a changé dans les logs et les traces ;
- si les symptômes ont commencé avant ou après le déploiement ;
- si des services non modifiés présentent les mêmes erreurs.
Si les erreurs précèdent le déploiement, l’assistant doit explorer d’autres pistes. L’équipe vérifie les preuves et confirme la cause ; la proximité temporelle avec une mise en production ne suffit pas à l’établir.
L’assistant peut également transformer les résultats de l’investigation en un compte rendu structuré : chronologie, composants touchés, observations et hypothèses restantes. Un collègue qui reprend l’incident retrouve ce qui a été examiné, les conclusions étayées et les questions encore ouvertes.
Retour de terrain : un diagnostic accéléré grâce à Dynatrace Davis
« Sur une application bancaire critique (Java/WebLogic), confrontée à d’importants ralentissements et à des interruptions en production, j’ai utilisé Dynatrace Davis pour accélérer l’investigation. L’IA a corrélé les pics de temps de réponse des transactions aux serveurs applicatifs et écarté plusieurs pistes (base de données, CPU, réseau, heap), orientant rapidement l’équipe vers la couche applicative.
L’analyse approfondie des méthodes et des threads a ensuite révélé que chaque requête recompilait les mêmes feuilles de style XSL derrière un verrou global : jusqu’à 213 des 239 threads étaient bloqués, avec également une fuite de mémoire native. La correction identifiée consistait à mettre en cache les modèles compilés. Le diagnostic a pris quelques jours, là où plusieurs semaines de réunions d’investigation auraient pu être nécessaires. Davis a facilité le triage et réduit le bruit des alertes ; l’identification précise de la cause est restée le travail de l’équipe. »
💡 L’avis de Qim info : demandez à l’assistant de préciser ce qui soutient chaque hypothèse et ce qui pourrait la remettre en cause. Une investigation utile doit permettre à l’équipe de décider quoi vérifier ensuite, en s’appuyant sur des éléments consultables.
Comment nous avons réduit les coûts du cloud d’une banque internationale ?
18 mois après la migration d’une plateforme on-premise vers le cloud, le résultat n’était pas à la hauteur des attentes. Découvrez comment Qim info est intervenu pour résoudre les dysfonctionnements et réduire les coûts d’exploitation. Le cas client
Exemple : deux incidents réels rejoués pour tester le diagnostic par l’IA
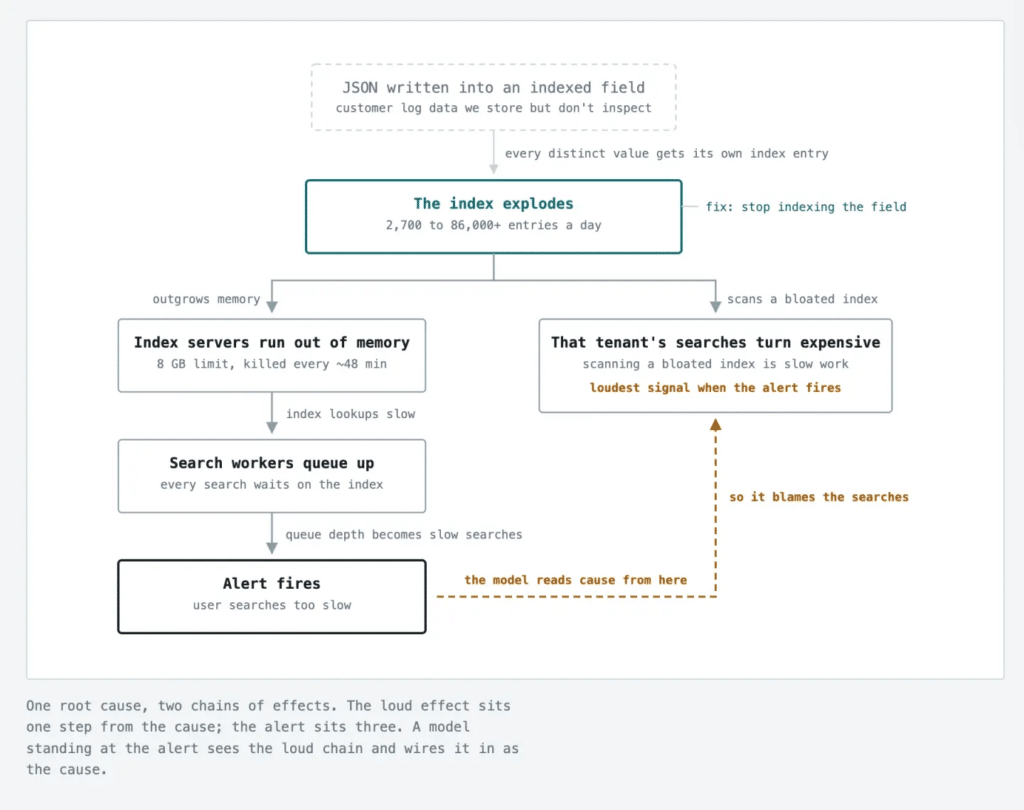
Une cause correctement identifiée dans 1 essai sur 16 avec la télémétrie seule, contre 15 sur 16 avec un contexte structuré sur le système : c’est le résultat d’une expérimentation menée par Grafana sur un incident réel, rejoué dans deux configurations.
Dans ce premier test, le Knowledge Graph aide l’agent à remonter plusieurs étapes en amont de l’alerte. Un second incident permet de vérifier si cet apport se retrouve dans un autre contexte.
1️⃣ Le symptôme : des recherches de logs deviennent lentes.
Un changement dans les données indexées fait grossir un index jusqu’à dépasser la mémoire disponible. Les serveurs redémarrent à répétition, et les recherches ralentissent. Une forte activité de requêtes apparaît aussi : elle peut sembler responsable, alors qu’elle est une conséquence du problème.
2️⃣ Le test : fournir l’alerte à un agent IA.
Grafana rejoue l’incident 16 fois par configuration :
- avec accès à la télémétrie seule ;
- avec accès à la télémétrie et au Knowledge Graph, qui décrit notamment les dépendances entre composants.
3️⃣ Les résultats : une différence marquée sur ce cas.
| Configuration | Cause correcte identifiée |
| Télémétrie seule | 1 essai sur 16 |
| Télémétrie et Knowledge Graph | 15 essais sur 16 |
Sans le graphe, l’agent désigne la forte activité de requêtes comme responsable dans 10 essais sur 16.
Ce que nous en retenons : dans ce premier cas, le Knowledge Graph a permis à l’agent de remonter beaucoup plus souvent à l’origine des lenteurs, plutôt que de s’arrêter à une forte activité de requêtes qui n’était qu’un symptôme. La correction consistait à cesser d’indexer le champ concerné.
4️⃣ Un second incident où le graphe n’apporte pas de gain significatif.
Grafana a également rejoué un incident provoqué par un backend ralenti : les requêtes s’accumulaient dans le service qui l’appelait, jusqu’à entraîner son arrêt par manque de mémoire. La preuve décisive se trouvait dans une ligne de log identifiant le backend en cause, et non dans le Knowledge Graph.
Résultat : 8 diagnostics corrects sur 16 avec le graphe, contre 7 sur 16 avec la télémétrie seule. L’écart n’est pas statistiquement significatif. Dans les essais infructueux, l’agent a manqué la ligne de log décisive, avec ou sans graphe.
💡 Le point de vue de Qim info : l’enjeu n’est pas d’accumuler le plus de contexte possible, mais de rendre accessibles les informations qui éclairent réellement l’incident : dépendances entre composants, métriques, logs, traces ou changements récents. Le Knowledge Graph a fortement amélioré le diagnostic dans le premier test, sans bénéfice notable dans le second. Ces résultats, obtenus sur deux incidents rejoués, ne constituent pas une garantie pour tous les environnements.
Quels prérequis pour tirer parti de l’IA en observabilité ?
Pour accélérer les investigations, l’IA doit pouvoir exploiter les bons signaux et produire des résultats que l’équipe peut vérifier. Trois points sont à préparer.
Des données exploitables
Vérifiez que l’assistant accède aux composants, dépendances et signaux utiles à la question posée : métriques, logs, traces et événements de déploiement. Les données doivent couvrir l’incident et une période de comparaison pertinente.
Des horodatages cohérents, des services et versions clairement identifiés et des liens entre les signaux facilitent l’analyse. Repérez aussi les lacunes de collecte, de filtrage ou d’échantillonnage : un assistant qui ne voit pas les appels vers une base de données peut manquer leur rôle dans un ralentissement.
💡 Le conseil de Qim info : vérifiez où l’assistant a cherché et ce qu’il pouvait consulter. Une erreur non détectée peut simplement se trouver hors de son champ d’analyse.
Les accès, la confidentialité et le traitement des données
Définissez :
- les sources et les environnements accessibles,
- l’identité utilisée pour les interroger
- et les personnes autorisées à consulter les conversations et les rapports.
L’assistant doit respecter les droits d’accès prévus pour cet usage.
Avant toute transmission, retirez les champs inutiles et masquez les informations sensibles qui ne doivent pas être exposées, tout en préservant le contexte nécessaire au diagnostic.
Vérifiez auprès du fournisseur où les données sont traitées, quels services les reçoivent, combien de temps elles sont conservées, comment elles sont supprimées et si elles servent à entraîner des modèles. Le lieu de stockage de votre télémétrie ne suffit pas à répondre à ces questions.
Comment nous avons modernisé la supervision des applications métiers d’une administration fiscale ?
Les lenteurs récurrentes perturbent les processus internes et la supervision en place était limitée. Découvrez comment nos équipes ont déployé une solution d’observabilité pour comprendre et résoudre les problèmes. Le cas client
Les règles à fixer avant de confier une investigation ou une action à l’IA
Demandez à l’assistant de présenter :
- les éléments qui soutiennent son diagnostic,
- le périmètre analysé
- et les incertitudes restantes.
L’équipe doit pouvoir consulter les preuves et décider quoi vérifier ensuite.
Si l’outil peut intervenir sur le système, définissez ses autorisations avant de l’utiliser. Un diagnostic correct ne suffit pas à autoriser un redémarrage en production.
| Question | Exemple de règle à définir |
| Que peut-il faire seul ? | Consulter les sources prévues et produire un rapport dans le périmètre autorisé. |
| Quelles actions faut-il valider ou interdire ? | Désigner qui valide un redémarrage ou une modification en production ; interdire les actions hors périmètre. |
| Comment contrôler le résultat ? | Vérifier l’effet obtenu, conserver la trace de l’action et prévoir un retour arrière lorsque c’est possible. |
Par quel usage commencer et comment évaluer les résultats ?
Nous vous proposons un protocole d’essai simple.
1️⃣ Choisissez une tâche précise et récurrente.
Par exemple : retrouver les erreurs d’un service sur une période donnée. Définissez le résultat attendu avant le test.
« Tester l’IA sur notre observabilité » est trop large pour tirer une conclusion utile.
2️⃣ Préparez quelques cas représentatifs.
- Choisissez des cas correspondant à la tâche, avec un résultat de référence vérifié.
- Pour tester l’aide au diagnostic, utilisez des incidents documentés, avec les données disponibles au moment de l’investigation.
- Ne fournissez pas à l’assistant le compte rendu qui contient déjà la solution.
- Incluez un cas où les informations sont insuffisantes, pour vérifier si l’assistant signale cette limite plutôt que de proposer une conclusion non étayée.
3️⃣ Comparez la méthode habituelle et la méthode assistée.
Comparez les deux méthodes sur le même périmètre, avec les mêmes données et les mêmes critères de réussite.
| À mesurer | Ce qu’il faut examiner |
| Temps total | Recherche, formulation des demandes, vérification et corrections. |
| Justesse | Conformité aux faits connus, erreurs, omissions importantes et conclusions non étayées. |
| Travail de vérification | Contrôles et reprises nécessaires avant d’utiliser le résultat. |
| Coût d’utilisation | Utilisation de l’assistant et requêtes supplémentaires, lorsqu’elles sont facturées. |
🚨 Attention à un biais : une personne qui connaît déjà la solution peut résoudre le cas plus vite. Un rejeu permet d’évaluer l’outil, mais ne suffit pas à démontrer le gain en conditions réelles.
4️⃣ Décidez selon des critères fixés à l’avance.
Par exemple : conserver cet usage si le temps total diminue, sans dégrader la justesse ni dépasser le coût accepté.
Si le test est concluant, poursuivez sur un périmètre limité en conditions réelles. Avant un déploiement plus large, évaluez également les coûts de configuration, d’intégration et de maintenance.
Retour de terrain : au moins 2 heures gagnées avec Grafana Assistant
Haytham, ingénieur chez Qim info, devait configurer Grafana Alloy pour recevoir uniquement des données OTLP et les transmettre à Grafana Cloud.
Plutôt que de parcourir la documentation pour simplifier la configuration générée par défaut, il a demandé à Grafana Assistant de produire les fichiers nécessaires.
Lors du déploiement, un conflit avec une ressource Kubernetes existante a provoqué une erreur. L’assistant lui a suggéré de déployer Alloy sous un autre nom.
Résultat : au moins deux heures d’expérimentation économisées, selon l’estimation d’Haytham.
Quelles évolutions pour l’IA en observabilité ?
Des investigations plus complètes. Les assistants peuvent enchaîner les requêtes, tester des hypothèses et produire un rapport étayé. Les métriques, logs et traces sont rapprochés du contexte du système : dépendances entre services, changements récents et procédures de l’équipe.
Une intégration aux outils de l’équipe. L’assistant peut rejoindre les échanges dans Slack ou Teams, créer un ticket ou partager un compte rendu. L’objectif est de faciliter le passage du constat à l’investigation, puis à la prochaine action.
Vers l’AI SRE. La perspective est de détecter et corriger certains incidents sans intervention humaine à chaque étape, afin de réduire les sollicitations d’astreinte. Les agents SRE vont dans cette direction, avec des actions préautorisées ou soumises à validation selon leur impact.
Préparer ces usages commence aujourd’hui : rendre la télémétrie et le contexte accessibles à l’IA, puis éprouver les diagnostics et les règles d’intervention sur un périmètre défini.
Comment nous avons diagnostiqué les ralentissements des applications métiers d’un groupe d’assurance sans perturber les environnements en place ?
Nos équipes ont utilisé le Diagnostic Rapide de Performance applicative pour comprendre l’origine des lenteurs et proposer un plan d’actions hiérarchisé. Le cas client
Par où commencer ?
L’IA peut accélérer la détection, l’exploration et le diagnostic si elle dispose de données utiles et si ses conclusions restent vérifiables. Le bon point de départ dépend de votre situation :
- Votre supervision est encore fragmentée : rapprochez les métriques et les logs, harmonisez les noms des services et les horodatages, et utilisez un standard commun comme OpenTelemetry lorsque c’est pertinent. La qualité et l’accessibilité des données sont la première étape.
- Vos données sont solides, mais les alertes vous submergent : commencez par la détection des écarts au comportement habituel et le regroupement des alertes liées à un même incident. Après quelques semaines, mesurez les dégradations détectées et le temps consacré aux alertes.
- Votre télémétrie est bien reliée et vos investigations sont structurées : testez le diagnostic sur quelques incidents passés avec le protocole en quatre étapes présenté plus haut. Limitez d’abord l’assistant à l’analyse ; toute capacité d’action doit faire l’objet d’une autorisation distincte.
💡 Le conseil de Qim info : quel que soit votre point de départ, une réponse de l’IA reste une piste à vérifier avant de conclure.
Quel accompagnement avec Qim info ?
Qim info vous accompagne pour choisir un premier usage, préparer les données et les accès, puis tester l’IA dans votre environnement. Nous comparons les résultats, le travail de vérification et les coûts pour décider de poursuivre, d’ajuster ou d’abandonner cet usage.
Échangez avec notre équipe Performance & Observability sur votre premier cas d’usage.
🧪 Chez Qim info, nous expérimentons aussi
Un défi lancé en interne : tester l’assistant IA de Grafana Cloud en créant un dashboard à partir de données publiques suisses.
Nos équipes ont ainsi construit l’« Awesome Swiss Dashboard », qui rassemble notamment des horaires de trains régionaux et des données météo accessibles via des API publiques.
Cette expérimentation explore l’aide de l’IA à la création de tableaux de bord. Elle complète notre travail sur l’observabilité, sans constituer un test de diagnostic d’incident.