Anomalien erkennen, Daten in natürlicher Sprache abfragen, die Diagnose beschleunigen: Observability-Plattformen nutzen KI, um den Umfang der Analysen, die Teams durchführen können, zu erweitern.
Inwieweit kann man sich auf diese Tools verlassen, und welche Informationen benötigen sie, um nützliche Antworten zu liefern?
Unsere Erfahrung zeigt, dass ihre Effizienz weitgehend von der Qualität der ihnen zur Verfügung gestellten Informationen abhängt. Ein Experiment von Grafana veranschaulicht dies: Ein KI-Agent wurde mit und ohne Zugriff auf den Knowledge Graph bewertet, die Kontextschicht von Grafana Cloud, die die Systemkomponenten, ihre Beziehungen und ihren Betriebsstatus abbildet.
Bei der Analyse eines nachgestellten tatsächlichen Vorfalls fand der Mitarbeiter mithilfe des Diagramms in 15 von 16 Versuchen die richtige Ursache, während er allein anhand der Telemetriedaten nur in einem von 16 Fällen fündig wurde. Bei einem anderen Vorfall führte die Hinzunahme des Diagramms jedoch zu keiner nennenswerten Verbesserung.
Auf der Grundlage dieser Ergebnisse und der Rückmeldungen der Qim-Info-Teams aus der Praxis untersuchen wir die Anwendungsfälle, Voraussetzungen und Methoden zur Bewertung von KI für die Observability in Ihrer Umgebung.
Die wichtigsten Punkte im Überblick:
- KI kann bestimmte Aufgaben automatisieren. Ihre Rolle geht über die eines Chatbots hinaus.
- Der Kontext ist ebenso wichtig wie die verfügbaren Kennzahlen, um ein Ergebnis zu interpretieren.
- Eine plausible Diagnose muss noch überprüft werden.
- Die der KI erteilte Erlaubnis zur Analyse ist keine Erlaubnis zum Handeln.
Welchen Zweck erfüllt KI im Rahmen eines Observability-Ansatzes?
Abgesehen von der Zeitersparnis ermöglicht die KI Analysen, die manuell nur schwer durchzuführen sind:
- Anomalien in mehrdimensionalen Daten erkennen,
- sehr große Mengen an Log-Daten zu durchsuchen,
- Code zu verstehen, der in einer Sprache geschrieben ist, die das Team nur unzureichend beherrscht.
Diese Funktionen eröffnen neue Möglichkeiten, Probleme zu erkennen und zu lösen.
Anomalien erkennen und zugehörige Warnmeldungen bündeln
Mithilfe der KI lassen sich Abweichungen erkennen, die bei festen Schwellenwerten übersehen würden, indem das übliche Verhalten des Systems analysiert wird.
Beispiel: Eine Anwendung kann langsamer werden, ohne ihren Alarmschwellenwert zu überschreiten. Wenn sie normalerweise innerhalb von 100 bis 200 ms antwortet und dauerhaft auf 600 ms ansteigt, löst ein auf eine Sekunde festgelegter Schwellenwert keine Warnung aus; ein Modell, das ihr übliches Verhalten analysiert, kann diese Abweichung jedoch erkennen.
KI hilft auch dabei, Warnmeldungen, die sich auf denselben Vorfall beziehen, gemeinsam zu prüfen. Ein Ausfall kann eine ganze Reihe von Symptomen auslösen:
Stellen wir uns Folgendes vor:
- eine Datenbank, die langsam wird;
- die APIs, die sie abfragen, benötigen länger, um zu antworten;
- Benutzeranfragen laufen schließlich ab.
Sollten drei separate Untersuchungen eingeleitet werden?
Das Tool kann diese Signale miteinander in Verbindung bringen, indem es deren zeitlichen Ablauf und die Abhängigkeiten zwischen den Komponenten untersucht. Dem Team steht dann eine Reihe von Symptomen zur Verfügung, die gemeinsam untersucht werden müssen. Und vergessen Sie vor allem nicht, dass „zusammenhängend“ nicht gleichbedeutend mit „nachgewiesener Ursache“ ist.
Diese Anwendungsfälle werden von Dynatrace als Referenzwerte für das normale Verhalten und zur Erkennung von Anomalien dokumentiert.
💡Die Empfehlung von Qim info: Konzentrieren Sie sich auf die Schwierigkeiten, mit denen Ihre Teams konfrontiert sind. Liegen Störungen unterhalb der Schwellenwerte? Prüfen Sie die verhaltensbasierte Erkennung. Führen mehrere Warnmeldungen zu separaten Untersuchungen desselben Vorfalls? Prüfen Sie die Möglichkeit, diese zusammenzufassen. Messen Sie anschließend die tatsächlich erkannten Störungen und den Arbeitsaufwand für die Bearbeitung der Warnmeldungen.
👉 Welche Kennzahlen sollten angezeigt werden und wie lässt sich Ihr Dashboard am besten strukturieren? In unserem Artikel zumIT-Performance-Dashboard gehen wir näher auf diese Entscheidungen ein. Informationen dazu, welche Komponenten überwacht und welche Warnmeldungen eingerichtet werden sollten, finden Sie in unserem Leitfaden zur IT-Überwachung.
Daten in natürlicher Sprache erkunden
Um Observability-Daten zu untersuchen, muss man oft wissen, wie man sie abfragt. Die natürliche Sprache baut diese technische Hürde ab: Der Benutzer formuliert, wonach er sucht, und der Assistent übernimmt die Erstellung der Abfragen.
„Bei welchen Diensten ist seit 14 Uhr ein Anstieg der Fehlerquote zu verzeichnen?“
Ausgehend von dieser Frage fragt der Assistent die verbundenen Quellen ab und zeigt die Ergebnisse an. Der Nutzer kann dann weiter nachfragen:
- „Konzentriere dich auf den Zahlungsdienst.“
- „Vergleiche die Fehlerquote mit der des gestrigen Zeitraums.“
- „Zeige die Protokolle oder Trace-Daten zu diesen Fehlern an.“
Für einen Mitarbeiter, der mit Abfragesprachen noch nicht so vertraut ist, eröffnet dies einen direkteren Zugang zur Datenauswertung.
Für einen Experten bietet dies die Möglichkeit, das Verfassen von Abfragen zu delegieren und sich auf die zu untersuchenden Ansätze zu konzentrieren.
Der Nutzen geht also über die Vereinfachung einer Abfrage hinaus: Der Assistent begleitet eine Erkundung, die sich im Laufe der Ergebnisse immer weiter präzisiert. Der Nutzer behält die Kontrolle über die Analyse und überprüft, ob der gewählte Zeitraum, das Umfeld und die Filter seiner Fragestellung entsprechen.
👉 Weitere Informationen zu Ladezeiten, den Core Web Vitals und dem Caching finden Sie in unserem Artikel zur Leistung von Webanwendungen. Unser Leitfaden zur Leistung mobiler Anwendungen befasst sich insbesondere mit der Flüssigkeit der Benutzeroberfläche, dem Speicher- und Akkuverbrauch sowie den Netzwerkeinschränkungen.
Unterstützung bei der Diagnose und Zusammenfassung der Vorfälle
Erfahrungsbericht aus der Praxis: Komplexe Untersuchungen, die nun nur noch wenige Minuten dauern – früher dauerte das einen ganzen Tag
Alan, Ingenieur bei Qim info, berichtet von komplexen Untersuchungen, die nun in 30 bis 60 Minuten durchgeführt werden, während sie früher einen ganzen Tag in Anspruch nahmen. Dieses Beispiel verdeutlicht den möglichen Zeitgewinn; dieser muss jedoch in jeder Umgebung noch genau ermittelt werden.
Der Assistent kann verschiedene Quellen auswerten, Symptome miteinander in Verbindung bringen und fundierte Hypothesen aufstellen. Dem Team steht somit eine erste Analyse zur Verfügung, die überprüft und vertieft werden kann.
Seit 14 Stunden treten nach einer Bereitstellung vermehrt Fehler auf. Um deren Ursache zu ermitteln, kann der Assistent Folgendes untersuchen:
- welche Dienste und welche Anfragen betroffen sind;
- was sich in den Protokollen und Trace-Daten geändert hat;
- ob die Symptome vor oder nach der Bereitstellung aufgetreten sind;
- ob unveränderte Dienste dieselben Fehler aufweisen.
Treten die Fehler vor der Bereitstellung auf, muss der Assistent andere Möglichkeiten in Betracht ziehen. Das Team überprüft die Nachweise und bestätigt die Ursache; die zeitliche Nähe zu einer Produktionsfreigabe reicht nicht aus, um diese festzustellen.
Der Assistent kann die Ergebnisse der Untersuchung zudem in einen strukturierten Bericht umwandeln: Zeitablauf, betroffene Komponenten, Beobachtungen und noch offene Hypothesen. Ein Kollege, der den Vorfall weiterbearbeitet, findet dort die untersuchten Sachverhalte, die fundierten Schlussfolgerungen und die noch offenen Fragen vor.
Erfahrungsbericht aus der Praxis: Schnellere Fehlerdiagnose dank Dynatrace Davis
„Bei einer kritischen Bankanwendung (Java/WebLogic), bei der es zu erheblichen Verzögerungen und Ausfällen im Produktivbetrieb kam, habe ich Dynatrace Davis eingesetzt, um die Untersuchung zu beschleunigen. Die KI hat die Spitzenwerte bei den Transaktionsantwortzeiten mit den Anwendungsservern in Zusammenhang gebracht und mehrere Ursachen (Datenbank, CPU, Netzwerk, Heap) ausgeschlossen, wodurch das Team schnell auf die Anwendungsebene gelenkt wurde.“
Eine eingehende Analyse der Methoden und Threads ergab anschließend, dass jede Anfrage dieselben XSL-Stylesheets hinter einer globalen Sperre neu kompilierte: Bis zu 213 der 239 Threads waren blockiert, wobei zudem ein nativer Speicherverlust auftrat. Die ermittelte Abhilfe bestand darin, die kompilierten Vorlagen zwischenzuspeichern. Die Diagnose dauerte einige Tage, während sonst möglicherweise mehrere Wochen an Besprechungen zur Ursachenermittlung erforderlich gewesen wären. Davis erleichterte die Einordnung und reduzierte das Alarmrauschen; die genaue Ermittlung der Ursache blieb jedoch Aufgabe des Teams.“
💡 Der Tipp von Qim info: Bitten Sie den Assistenten, zu erläutern, worauf sich die jeweilige Hypothese stützt und was sie in Frage stellen könnte. Eine sinnvolle Recherche soll es dem Team ermöglichen, auf der Grundlage von einsehbaren Informationen zu entscheiden, was als Nächstes überprüft werden soll.
Wie wir die Cloud-Kosten einer internationalen Bank gesenkt haben?
18 Monate nach der Migration von einer On-Premise-Plattform in die Cloud entsprach das Ergebnis nicht den Erwartungen. Erfahren Sie, wie Qim info eingegriffen hat, um die Störungen zu beheben und die Betriebskosten zu senken. Der Kundenfall
Beispiel: Zwei reale Vorfälle, die zum Test der KI-Diagnose nachgestellt wurden
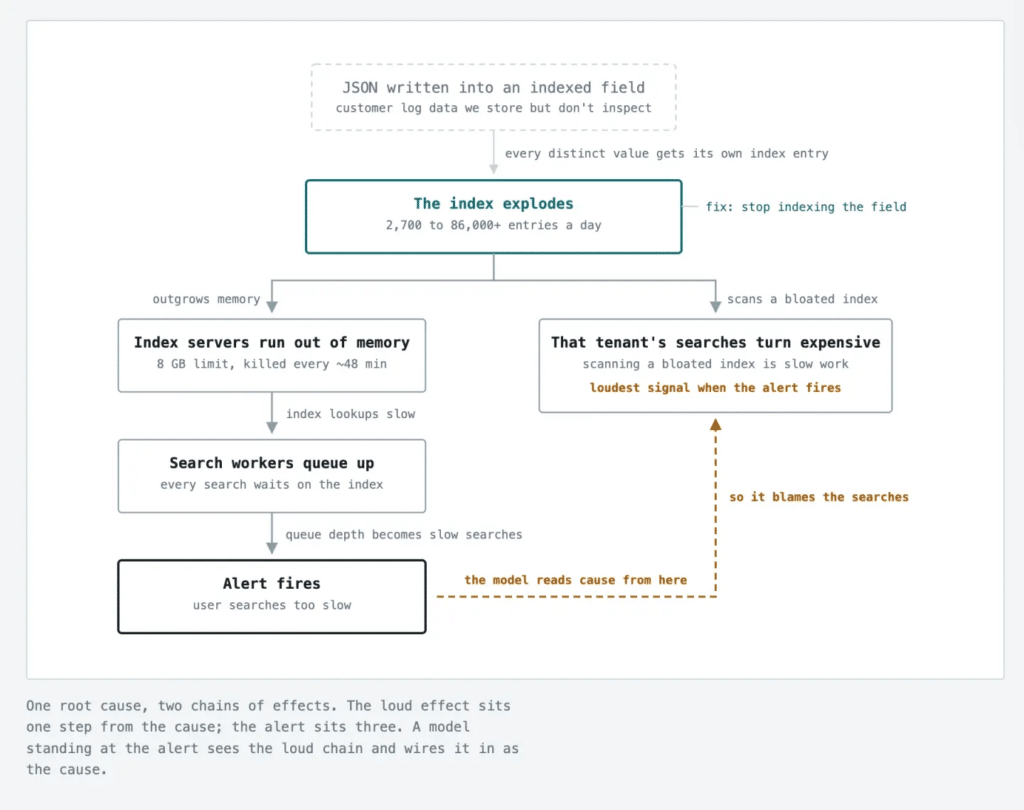
Eine korrekt identifizierte Ursache in 1 von 16 Versuchen mit reiner Telemetrie, gegenüber 15 von 16 mit einem strukturierten Kontext im System: Das ist das Ergebnis eines von Grafana durchgeführten Experiments an einem realen Vorfall, der in zwei Konfigurationen nachgestellt wurde.
In diesem ersten Test hilft der Knowledge Graph dem Mitarbeiter, mehrere Schritte vor dem Alarm zurückzuverfolgen. Anhand eines zweiten Vorfalls lässt sich überprüfen, ob dieser Beitrag auch in einem anderen Kontext zum Tragen kommt.
1️⃣ Das Symptom: Die Suche in den Logs wird langsam.
Eine Änderung an den indizierten Daten führt dazu, dass ein Index so stark anwächst, dass er den verfügbaren Speicherplatz überschreitet. Die Server starten wiederholt neu, und die Suchvorgänge werden langsamer. Zudem tritt eine hohe Abfrageaktivität auf: Diese scheint zunächst die Ursache zu sein, ist jedoch lediglich eine Folge des Problems.
2️⃣ Der Test: Die Warnmeldung an einen KI-Agenten weiterleiten.
Grafana spielt den Vorfall 16 Mal pro Konfiguration nach:
- mit Zugriff ausschließlich auf die Telemetrie;
- mit Zugriff auf Telemetrie und den Knowledge Graph, der insbesondere die Abhängigkeiten zwischen den Komponenten beschreibt.
3️⃣ Die Ergebnisse: In diesem Fall ist ein deutlicher Unterschied zu erkennen.
| Konfiguration | Ursache korrekt identifiziert |
| Nur Telemetrie | 1 von 16 Versuchen |
| Telemetrie und Knowledge Graph | 15 von 16 Versuchen |
Ohne die Grafik macht der Mitarbeiter in 10 von 16 Versuchen die hohe Abfrageaktivität dafür verantwortlich.
Was wir daraus lernen: In diesem ersten Fall ermöglichtees der Knowledge Graph dem Mitarbeiter, die Ursachen für die Verzögerungen wesentlich häufiger aufzuspüren, anstatt sich nur auf eine hohe Abfrageaktivität zu beschränken, die lediglich ein Symptom war. Die Behebung bestand darin, die Indizierung des betreffenden Feldes einzustellen.
4️⃣ Ein zweiter Vorfall, bei dem der Graph keinen nennenswerten Nutzen brachte.
Grafana hat zudem einen Vorfall nachgestellt, der durch ein verlangsamtes Backend verursacht wurde: Die Anfragen stauten sich in dem Dienst, der das Backend aufrief, bis dieser schließlich aufgrund von Speichermangel abstürzte. Der entscheidende Beweis lag in einer Log-Zeile, die das betreffende Backend identifizierte, und nicht im Knowledge Graph.
Ergebnis: 8 richtige Diagnosen von 16 mit der Grafik, gegenüber 7 von 16 mit der Telemetrie allein. Der Unterschied ist statistisch nicht signifikant. Bei den erfolglosen Versuchen hat der Mitarbeiter die entscheidende Log-Zeile übersehen, sowohl mit als auch ohne Grafik.
💡 Die Sichtweise von Qim info: Es geht nicht darum, so viel Kontext wie möglich zu sammeln, sondern jene Informationen zugänglich zu machen, die tatsächlich Aufschluss über den Vorfall geben: Abhängigkeiten zwischen Komponenten, Metriken, Protokolle, Trace-Daten oder kürzlich vorgenommene Änderungen. Der Knowledge Graph hat die Diagnose im ersten Test deutlich verbessert, im zweiten Test hingegen keinen nennenswerten Nutzen gebracht. Diese Ergebnisse, die anhand von zwei nachgestellten Vorfällen erzielt wurden, stellen keine Garantie für alle Umgebungen dar.
Welche Voraussetzungen müssen erfüllt sein, um die Vorteile der KI im Bereich der Observability zu nutzen?
Um die Untersuchungen zu beschleunigen, muss die KI in der Lage sein, die richtigen Signale zu nutzen und Ergebnisse zu liefern, die das Team überprüfen kann. Dazu sind drei Punkte zu beachten.
Verwertbare Daten
Stellen Sie sicher, dass der Assistent auf die für die gestellte Frage relevanten Komponenten, Abhängigkeiten und Signale zugreift: Metriken, Protokolle, Traces und Bereitstellungsereignisse. Die Daten müssen den Vorfall sowie einen relevanten Vergleichszeitraum abdecken.
Konsistente Zeitstempel, eindeutig identifizierte Dienste und Versionen sowie Verknüpfungen zwischen den Signalen erleichtern die Analyse. Achten Sie auch auf Lücken bei der Erfassung, Filterung oder Stichprobenentnahme: Ein Assistent, der Aufrufe an eine Datenbank nicht erkennt, könnte deren Rolle bei einer Verlangsamung übersehen.
💡 Der Tipp von Qim info: Überprüfen Sie, wo der Assistent gesucht hat und welche Daten er einsehen konnte. Ein unentdeckter Fehler kann sich einfach außerhalb seines Analysebereichs befinden.
Zugriff, Datenschutz und Datenverarbeitung
Definieren Sie:
- die zugänglichen Quellen und Umgebungen,
- die für die Abfrage verwendete Identität
- sowie die Personen, die berechtigt sind, die Unterhaltungen und Berichte einzusehen.
Der Assistent muss die für diesen Zweck vorgesehenen Zugriffsrechte einhalten.
Entfernen Sie vor jeder Übermittlung nicht benötigte Felder und maskieren Sie sensible Informationen, die nicht offengelegt werden dürfen, wobei Sie den für die Diagnose erforderlichen Kontext beibehalten sollten.
Erkundigen Sie sich beim Anbieter, wo die Daten verarbeitet werden, welche Dienste sie erhalten, wie lange sie aufbewahrt werden, wie sie gelöscht werden und ob sie zum Trainieren von Modellen verwendet werden. Der Speicherort Ihrer Telemetriedaten reicht nicht aus, um diese Fragen zu beantworten.
Wie haben wir die Überwachung der Fachanwendungen einer Steuerbehörde modernisiert?
Wiederkehrende Verzögerungen beeinträchtigen die internen Prozesse, und die bisherige Überwachung war nur begrenzt wirksam. Erfahren Sie, wie unsere Teams eine Observability-Lösung implementiert haben, um Probleme zu verstehen und zu beheben. Der Kundenfall
Regeln, die festgelegt werden müssen, bevor man der KI eine Untersuchung oder eine Aufgabe überträgt
Bitten Sie den Assistenten, Folgendes vorzustellen:
- die Faktoren, die seine Diagnose stützen,
- den analysierten Umfang
- sowie die verbleibenden Unsicherheiten.
Das Team muss die Nachweise einsehen und entscheiden können, was als Nächstes überprüft werden soll.
Wenn das Tool Eingriffe am System vornehmen kann, legen Sie dessen Berechtigungen fest, bevor Sie es verwenden. Eine korrekte Diagnose reicht nicht aus, um einen Neustart im Produktionsbetrieb zu genehmigen.
| Frage | Beispiel für eine zu definierende Regel |
| Was kann er alleine tun? | Die vorgesehenen Quellen einsehen und einen Bericht im genehmigten Rahmen erstellen. |
| Welche Aktionen müssen genehmigt oder untersagt werden? | Legen Sie fest, wer einen Neustart oder eine Änderung in der Produktion genehmigt; verbieten Sie Maßnahmen außerhalb des zulässigen Rahmens. |
| Wie lässt sich das Ergebnis überprüfen? | Überprüfen Sie die erzielte Wirkung, dokumentieren Sie die Maßnahme und sehen Sie nach Möglichkeit eine Rücknahme vor. |
Mit welcher Anwendung soll man beginnen und wie lassen sich die Ergebnisse bewerten?
Wir schlagen Ihnen ein einfaches Testverfahren vor.
1️⃣ Wählen Sie eine konkrete, regelmäßig wiederkehrende Aufgabe aus.
Beispiel: Fehler eines Dienstes in einem bestimmten Zeitraum aufspüren. Legen Sie vor dem Test das erwartete Ergebnis fest.
„Die KI hinsichtlich unserer Observability testen“ ist zu weit gefasst, um eine aussagekräftige Schlussfolgerung zu ziehen.
2️⃣ Bereiten Sie einige repräsentative Fälle vor.
- Wählen Sie Fälle aus, die der Aufgabe entsprechen und deren Referenzergebnis überprüft wurde.
- Um die Diagnosehilfe zu testen, verwenden Sie dokumentierte Vorfälle mit den zum Zeitpunkt der Untersuchung verfügbaren Daten.
- Geben Sie dem Assistenten keinen Bericht, der bereits die Lösung enthält.
- Fügen Sie einen Fall hinzu, bei dem die Informationen unzureichend sind, um zu überprüfen, ob der Assistent auf diese Einschränkung hinweist, anstatt eine unbegründete Schlussfolgerung vorzuschlagen.
3️⃣ Vergleichen Sie die herkömmliche Methode mit der unterstützten Methode.
Vergleichen Sie die beiden Methoden im gleichen Umfang, mit denselben Daten und denselben Erfolgskriterien.
| Zu prüfen | Was zu prüfen ist |
| Gesamtzeit | Recherche, Formulierung der Anfragen, Überprüfung und Korrekturen. |
| Korrektheit | Übereinstimmung mit den bekannten Fakten, Fehler, wesentliche Auslassungen und unbegründete Schlussfolgerungen. |
| Überprüfungsarbeit | Notwendige Kontrollen und Nachbesserungen vor der Verwendung des Ergebnisses. |
| Nutzungskosten | Nutzung des Assistenten und zusätzliche Anfragen, sofern diese in Rechnung gestellt werden. |
🚨 Vorsicht vor einer Verzerrung: Jemand, der die Lösung bereits kennt, kann den Fall schneller lösen. Ein Testdurchlauf ermöglicht zwar die Bewertung des Tools, reicht aber nicht aus, um den Nutzen unter realen Bedingungen nachzuweisen.
4️⃣ Treffen Sie Ihre Entscheidung anhand im Voraus festgelegter Kriterien.
Beispiel: Behalten Sie diese Anwendungsweise bei, wenn sich die Gesamtzeit verkürzt, ohne dass die Genauigkeit darunter leidet oder die akzeptierten Kosten überschritten werden.
Ist der Test erfolgreich, setzen Sie ihn in begrenztem Umfang unter realen Bedingungen fort. Bewerten Sie vor einer breiteren Einführung auch die Kosten für Konfiguration, Integration und Wartung.
Erfahrungsbericht aus der Praxis: Mindestens 2 Stunden Zeitersparnis mit dem Grafana Assistant
Haytham, Ingenieur bei Qim info, musste Grafana Alloy so konfigurieren, dass es ausschließlich OTLP-Daten empfängt und diese an Grafana Cloud weiterleitet.
Anstatt die Dokumentation zu durchforsten, um die standardmäßig generierte Konfiguration zu vereinfachen, bat er den Grafana Assistant, die erforderlichen Dateien zu erstellen.
Bei der Bereitstellung führte ein Konflikt mit einer bestehenden Kubernetes-Ressource zu einem Fehler. Der Assistent schlug ihm vor, Alloy unter einem anderen Namen bereitzustellen.
Ergebnis: Nach Haythams Schätzung wurden dadurch mindestens zwei Stunden Experimentierzeit eingespart.
Welche Entwicklungen gibt es bei der KI im Bereich der Observability?
Umfassendere Untersuchungen. Die Assistenten können Abfragen aneinanderreihen, Hypothesen testen und einen fundierten Bericht erstellen. Metriken, Protokolle und Ablaufverläufe werden mit dem Systemkontext in Verbindung gebracht: Abhängigkeiten zwischen Diensten, aktuelle Änderungen und Arbeitsabläufe des Teams.
Integration in die Tools des Teams. Der Assistent kann sich an Unterhaltungen in Slack oder Teams beteiligen, ein Ticket erstellen oder einen Bericht teilen. Ziel ist es, den Übergang von der Feststellung zur Untersuchung und schließlich zur nächsten Maßnahme zu erleichtern.
Auf dem Weg zur SRE-KI. Das Ziel besteht darin, bestimmte Vorfälle zu erkennen und zu beheben, ohne dass in jeder Phase ein menschliches Eingreifen erforderlich ist, um den Bedarf an Bereitschaftsdiensten zu reduzieren. Die SRE-Mitarbeiter bewegen sich in diese Richtung, mit Maßnahmen, die je nach ihren Auswirkungen entweder vorab genehmigt sind oder einer Validierung unterliegen.
Die Vorbereitung auf diese Anwendungsfälle beginnt bereits heute: Telemetriedaten und Kontextinformationen müssen für die KI zugänglich gemacht werden, anschließend müssen Diagnosen und Interventionsregeln in einem definierten Umfang getestet werden.
Wie haben wir die Leistungsengpässe bei den Fachanwendungen eines Versicherungskonzerns diagnostiziert, ohne die bestehenden Umgebungen zu beeinträchtigen?
Unsere Teams haben die „Schnelldiagnose zur Anwendungsleistung“ eingesetzt, um die Ursachen der Verzögerungen zu ermitteln und einen priorisierten Maßnahmenplan vorzuschlagen. Der Kundenfall
Wo soll man anfangen?
KI kann die Erkennung, Untersuchung und Diagnose beschleunigen, sofern sie über aussagekräftige Daten verfügt und ihre Schlussfolgerungen überprüfbar bleiben. Der richtige Ausgangspunkt hängt von Ihrer Situation ab:
- Ihre Überwachung ist noch immer fragmentiert: Führen Sie Metriken und Protokolle zusammen, vereinheitlichen Sie die Namen der Dienste und die Zeitstempel und nutzen Sie, wo sinnvoll, einen gemeinsamen Standard wie OpenTelemetry. Die Qualität und Zugänglichkeit der Daten sind der erste Schritt.
- Ihre Daten sind solide, aber Sie werden von Warnmeldungen überschwemmt: Beginnen Sie damit, Abweichungen vom üblichen Verhalten zu erkennen und Warnmeldungen, die sich auf denselben Vorfall beziehen, zusammenzufassen. Bewerten Sie nach einigen Wochen die festgestellten Beeinträchtigungen und den Zeitaufwand für die Bearbeitung der Warnmeldungen.
- Ihre Telemetrie ist ordnungsgemäß verbunden und Ihre Untersuchungen sind strukturiert: Testen Sie die Diagnose anhand einiger vergangener Vorfälle mit dem oben vorgestellten vierstufigen Protokoll. Beschränken Sie den Assistenten zunächst auf die Analyse; jede Handlungsbefugnis muss gesondert genehmigt werden.
💡 Der Tipp von Qim info: Unabhängig davon, wo Sie ansetzen – eine Antwort der KI sollten Sie auf jeden Fall überprüfen, bevor Sie Schlussfolgerungen ziehen.
Welche Unterstützung bietet Qim info?
Qim info unterstützt Sie dabei, einen ersten Anwendungsfall auszuwählen, die Daten und Zugriffsrechte vorzubereiten und anschließend die KI in Ihrer Umgebung zu testen. Wir vergleichen die Ergebnisse, den Verifizierungsaufwand und die Kosten, um zu entscheiden, ob dieser Anwendungsfall fortgeführt, angepasst oder aufgegeben werden soll.
Tauschen Sie sich mit unserem Team „Performance & Observability“ über Ihren ersten Anwendungsfall aus.
🧪 Auch wir bei Qim info experimentieren mit „
“ – einer intern gestarteten Herausforderung: den KI-Assistenten von Grafana Cloud zu testen, indem wir ein Dashboard auf Basis öffentlicher Schweizer Daten erstellen.
Unsere Teams haben sodas „Awesome Swiss Dashboard“ erstellt, das unter anderem Fahrpläne von Regionalzügen und Wetterdaten zusammenfasst, die über öffentliche APIs zugänglich sind.
Dieses Experiment untersucht den Einsatz von KI bei der Erstellung von Dashboards. Es ergänzt unsere Arbeit im Bereich der Observability, stellt jedoch keinen Test zur Fehlerdiagnose dar.